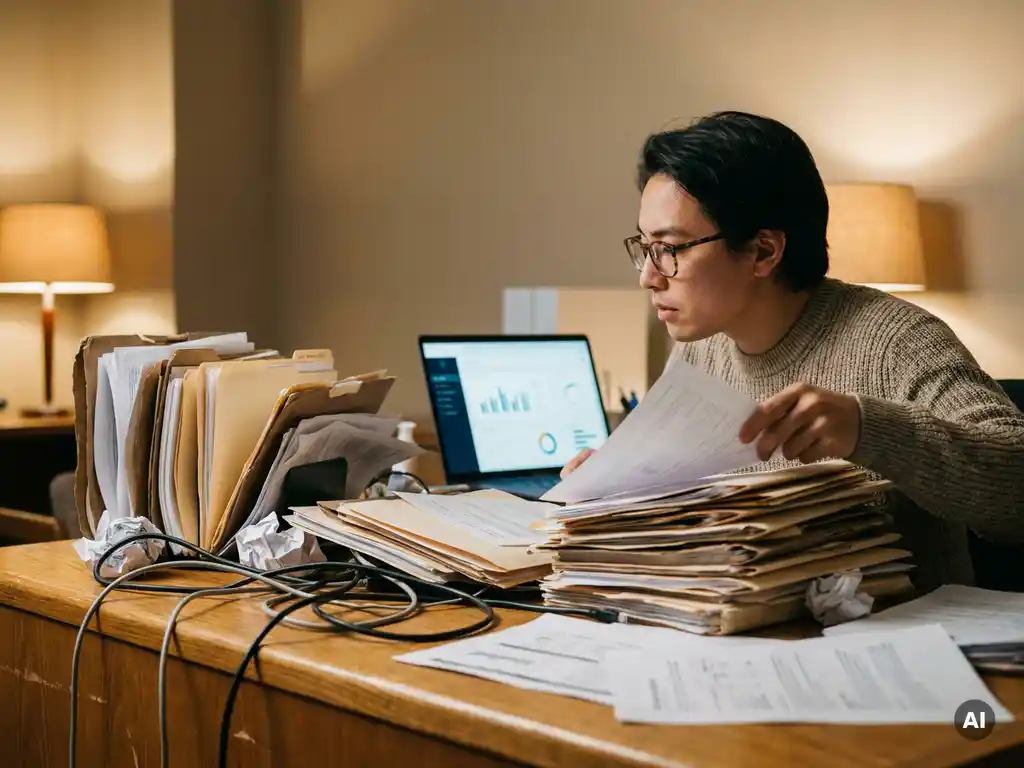
Het ophalen van betrouwbare data kost zoveel tijd omdat de informatie die je nodig hebt zelden op één plek staat. Data is verspreid over meerdere systemen, afdelingen en spreadsheets, en voordat je tot een betrouwbaar rapport kunt komen, moeten al die bronnen worden samengebracht, afgestemd en gecontroleerd. Dat proces is arbeidsintensief en foutgevoelig, zeker als definities per afdeling verschillen. De vragen hieronder gaan dieper in op de oorzaken en wat je eraan kunt doen.
Waar gaat de meeste tijd naartoe bij het ophalen van data?
De meeste tijd gaat niet naar het analyseren van data, maar naar het verzamelen, opschonen en samenvoegen ervan. In de praktijk besteden analisten en medewerkers een groot deel van hun tijd aan handmatige stappen die eigenlijk geautomatiseerd zouden moeten zijn. Data ophalen is tijdrovend omdat de route van ruwe informatie naar bruikbaar inzicht vol obstakels zit.
De meest voorkomende tijdvreters zijn:
- Handmatig exporteren en kopiëren uit meerdere systemen naar spreadsheets
- Opschonen van incomplete of foutieve invoer, zoals dubbele records, lege velden of verkeerd geformatteerde waarden
- Afstemmen met collega’s over welke versie van een getal de juiste is
- Wachten op toegang tot systemen of data die beheerd worden door andere teams
- Handmatig controleren of de uitkomst klopt voordat het rapport de deur uit gaat
Al deze stappen kosten tijd die eigenlijk aan interpretatie en besluitvorming besteed zou moeten worden. Zolang de route naar betrouwbare data niet is gestroomlijnd, blijft dit terugkerende overhead.
Waarom spreken cijfers uit verschillende systemen elkaar tegen?
Cijfers uit verschillende systemen spreken elkaar tegen omdat dezelfde begrippen in verschillende systemen anders worden gedefinieerd, gemeten of bijgehouden. Eén afdeling telt actieve klanten op basis van contractdatum, een andere op basis van facturatiestatus. Beide zijn intern consistent, maar samen leveren ze tegenstrijdige rapportages op.
Dit is een van de meest herkenbare problemen bij datakwaliteit in grotere organisaties. Het gaat niet altijd om fouten in de data zelf, maar om het ontbreken van gedeelde definities. Wanneer meerdere systemen naast elkaar zijn gegroeid, elk met hun eigen logica en beheerders, ontstaan er vanzelf interpretatieverschillen.
De gevolgen zijn merkbaar in de vergaderzaal: discussies over welk cijfer klopt, twijfel over de betrouwbaarheid van rapportages en besluiten die worden uitgesteld omdat niemand zeker weet welke bron leidend is. Zolang definities niet zijn geharmoniseerd en vastgelegd, blijven die discussies terugkomen.
Wat maakt data uit meerdere bronnen zo moeilijk te combineren?
Data uit meerdere bronnen combineren is moeilijk omdat systemen zijn gebouwd voor hun eigen doel, niet voor uitwisseling. Ze hanteren verschillende sleutels, structuren en indelingen. Een klantnummer in het ene systeem bestaat niet in het andere, of heeft een andere opbouw. Dat maakt data-integratie technisch complex en foutgevoelig.
Naast technische verschillen spelen ook organisatorische factoren een rol. Systemen worden beheerd door verschillende teams, die elk hun eigen prioriteiten en releasekalenders hebben. Een koppeling bouwen betekent dus niet alleen technisch werk, maar ook afstemming tussen afdelingen, akkoord op architectuur en afspraken over eigenaarschap en onderhoud.
Daar komt bij dat dataversnippering in de loop van de tijd groeit. Organisaties groeien, fuseren of digitaliseren processen stap voor stap, waarbij elk nieuw systeem een nieuwe silo toevoegt. Zonder een doordachte aanpak voor data-architectuur stapelen de integratievraagstukken zich op.
Hoe lang duurt het normaal gesproken om een betrouwbaar rapport op te leveren?
Hoe lang een betrouwbare rapportage duurt, hangt sterk af van de mate van dataversnippering en de volwassenheid van de data-infrastructuur. In organisaties zonder gestructureerde data-integratie kan een managementrapportage meerdere dagen handmatig werk kosten, terwijl dezelfde rapportage in een goed ingericht BI-landschap grotendeels geautomatiseerd beschikbaar is.
Het verschil zit in de mate van voorbereiding. Als bronnen al zijn gekoppeld, definities zijn vastgelegd en data-pipelines draaien, is een rapport ophalen een kwestie van minuten. Als dat fundament ontbreekt, begint elke rapportagecyclus opnieuw met handmatig werk: exporteren, samenvoegen, controleren, afstemmen.
Voor organisaties die stuurinformatie nodig hebben om tijdig bij te sturen, is die vertraging meer dan ongemakkelijk. Beslissingen worden dan genomen op basis van verouderde of onvolledige informatie, of ze worden uitgesteld totdat de data eindelijk rond is.
Wanneer is trage data-ontsluiting een incidenteel probleem en wanneer een structureel risico?
Trage data-ontsluiting is een structureel risico wanneer het de besluitvorming herhaaldelijk vertraagt, wanneer medewerkers structureel tijd kwijt zijn aan handmatige dataverzameling, of wanneer de organisatie niet tijdig kan reageren op afwijkingen in prestaties. Een eenmalig vertraagd rapport is vervelend; een patroon is een bestuurlijk probleem.
Er zijn signalen die aangeven dat het niet bij een incident blijft:
- Rapportages worden regelmatig te laat opgeleverd voor vergaderingen of beslismomenten
- Medewerkers houden eigen schaduwadministraties bij omdat ze de centrale data niet vertrouwen
- Discussies over de juistheid van cijfers keren elke periode terug
- Nieuwe informatiebehoefte kan niet worden ingevuld omdat de benodigde data niet beschikbaar of niet koppelbaar is
- Verantwoording richting bestuur, toezichthouder of financier verloopt moeizaam door gebrek aan betrouwbare onderbouwing
Wanneer meerdere van deze signalen herkenbaar zijn, is trage of onbetrouwbare data-ontsluiting geen technisch ongemak meer, maar een risico voor de besturing van de organisatie.
Welke aanpak lost het probleem structureel op?
Een structurele oplossing begint niet bij een tool of dashboard, maar bij de vraag waarop de organisatie wil sturen. Vanuit die informatiebehoefte worden de relevante bronnen, definities en technische koppelingen bepaald. Pas dan heeft een BI-rapportage of dashboard werkelijk waarde, omdat het is gebouwd op een betrouwbaar en gedeeld informatiemodel.
Concreet betekent dit:
- Vaststellen welke beslissingen worden genomen en welke informatie daarvoor nodig is
- Gezamenlijk definiëren wat begrippen als “omzet”, “bezetting” of “doorlooptijd” precies betekenen in de context van de organisatie
- Bronnen technisch koppelen via gestructureerde data-integratie, zodat handmatige stappen worden geëlimineerd
- Een datafundament inrichten dat beheersbaar is en aansluit op de bestaande technische omgeving
- Rapportages en dashboards bouwen die aansluiten op de manier waarop de organisatie daadwerkelijk beslissingen neemt
Dit vraagt om samenwerking tussen de business, die de informatiebehoefte kent, en de interne data- en IT-teams, die de systemen en architectuur beheren. Meer over deze aanpak is te vinden op de expertise-pagina.
Hoe DataGrow helpt bij betrouwbare data-ontsluiting
DataGrow helpt organisaties om de stap te zetten van versnipperde, tijdrovende data-ontsluiting naar betrouwbare stuurinformatie die beschikbaar is wanneer die nodig is. We werken daarbij altijd samen met de interne data- en IT-teams van de organisatie, niet ernaast of eromheen.
Wat we concreet doen:
- Informatiebehoefte in kaart brengen samen met verantwoordelijke business- en afdelingsleiders
- Definities harmoniseren zodat iedereen op basis van dezelfde cijfers stuurt
- Bronnen koppelen en data-pipelines inrichten binnen de bestaande technische omgeving van de organisatie
- Rapportages en dashboards realiseren die aansluiten op de beslissingen die de organisatie daadwerkelijk moet nemen
- Kennisoverdracht verzorgen zodat interne teams het fundament zelfstandig kunnen beheren en uitbreiden
Het resultaat is geen nieuw dashboard op zichzelf, maar een betrouwbaar informatiebeeld waarop managers, programmaverantwoordelijken en bestuurders kunnen sturen en verantwoorden. Wil je weten wat dit voor jouw organisatie kan betekenen? Neem contact op voor een vrijblijvend gesprek.
Veelgestelde vragen
Waar begin ik als mijn organisatie last heeft van versnipperde data maar geen grote IT-afdeling heeft?
Begin niet met technologie, maar met het in kaart brengen van de meest kritische informatiebehoefte: welke beslissingen worden het vaakst vertraagd of bemoeilijkt door slechte data? Dat geeft je een afgebakend startpunt waarmee je stap voor stap kunt werken, zonder meteen een grootschalig data-project te hoeven opzetten. Juist voor organisaties zonder grote IT-capaciteit is het belangrijk om klein en gericht te beginnen, zodat de eerste verbeteringen snel zichtbaar zijn en intern draagvlak creëren.
Hoe voorkom ik dat we over een jaar weer hetzelfde probleem hebben, ook na een verbetertraject?
Het risico op terugval is groot als definities en koppelingen niet worden vastgelegd en beheerd. Zorg daarom dat afspraken over begrippen zoals ‘omzet’ of ‘actieve klant’ gedocumenteerd worden in een gezamenlijk datawoordenboek, en dat er duidelijk eigenaarschap is over de data-pipelines en rapportages. Een goed ingericht datafundament is geen eenmalig project, maar vraagt om periodiek onderhoud en een interne eigenaar die verantwoordelijk is voor de continuïteit.
Wat is het verschil tussen een datawarehouse, een dataplatform en een BI-tool, en wat heb ik eigenlijk nodig?
Een datawarehouse of dataplatform is de plek waar data uit verschillende bronnen wordt samengebracht, opgeschoond en gestructureerd opgeslagen — dit vormt het fundament. Een BI-tool zoals Power BI of Tableau is de laag waarmee je die data visualiseert en rapporteert. Wat je nodig hebt, hangt af van je situatie: zonder een betrouwbaar fundament heeft de mooiste BI-tool weinig waarde, omdat de onderliggende data dan nog steeds onbetrouwbaar of onvolledig is.
Hoe overtuig ik mijn management om te investeren in een betere data-infrastructuur?
De sterkste argumenten zijn concreet en financieel: bereken hoeveel uren per maand medewerkers kwijt zijn aan handmatige dataverzameling en -controle, en vertaal dat naar kosten. Voeg daar de risico’s aan toe van beslissingen die zijn genomen op basis van verouderde of onjuiste data, zoals gemiste bijsturing of onjuiste verantwoording richting bestuur of financiers. Een concrete businesscase op basis van herkenbare knelpunten in de eigen organisatie is doorgaans overtuigender dan een abstract verhaal over data-volwassenheid.
Kunnen we bestaande systemen blijven gebruiken, of moeten we alles vervangen?
In de meeste gevallen hoeven bestaande systemen niet te worden vervangen. Een goede aanpak voor data-integratie werkt juist met de systemen die er al zijn, door ze via gestructureerde koppelingen samen te laten werken. Vervanging van een bronsysteem is alleen nodig als het systeem zelf de oorzaak is van structurele dataproblemen, niet als oplossing voor integratievraagstukken die ook oplosbaar zijn met slimme architectuurkeuzes.
Hoe lang duurt het gemiddeld voordat een data-integratietraject resultaat oplevert?
Dat hangt sterk af van de complexiteit van de situatie, maar in de praktijk zijn eerste tastbare resultaten — zoals een betrouwbaar operationeel dashboard of een geautomatiseerde rapportage — vaak binnen enkele weken tot maanden te realiseren als het traject goed is afgebakend. De sleutel is prioriteren: begin met de informatiebehoefte die de meeste waarde oplevert en bouw van daaruit verder, in plaats van te proberen alles tegelijk op te lossen.
Wat zijn veelgemaakte fouten bij het aanpakken van datakwaliteitsproblemen?
Een veelgemaakte fout is beginnen met een tool of dashboard zonder eerst het onderliggende datafundament op orde te brengen — het resultaat is dan een mooie visualisatie van onbetrouwbare data. Een andere valkuil is het niet betrekken van de business bij het definiëren van begrippen, waardoor technische oplossingen worden gebouwd die niet aansluiten op hoe de organisatie daadwerkelijk stuurt. Tot slot onderschatten veel organisaties het belang van eigenaarschap: zonder een duidelijke verantwoordelijke vervalt de situatie na verloop van tijd terug naar het oude patroon.
Gerelateerde artikelen
- Wanneer schiet een BI-tool tekort voor complexe organisaties?
- Waarom is datageletterdheid binnen management zo moeilijk te ontwikkelen?
- Hoe weet je wanneer je BI-omgeving toe is aan een herinrichting?
- Wat is het verschil tussen descriptieve en voorspellende data-analyse?
- Wat is het verschil tussen real-time data en near-real-time data?